07-阻塞队列
阻塞队列
基本介绍
有界队列和无界队列:
-
有界队列:有固定大小的队列,比如设定了固定大小的 LinkedBlockingQueue,又或者大小为 0
-
无界队列:没有设置固定大小的队列,这些队列可以直接入队,直到溢出(超过 Integer.MAX_VALUE),所以相当于无界
java.util.concurrent.BlockingQueue 接口有以下阻塞队列的实现:FIFO 队列
- ArrayBlockQueue:由数组结构组成的有界阻塞队列
- LinkedBlockingQueue:由链表结构组成的无界(默认大小 Integer.MAX_VALUE)的阻塞队列
- PriorityBlockQueue:支持优先级排序的无界阻塞队列
- DelayedWorkQueue:使用优先级队列实现的延迟无界阻塞队列
- SynchronousQueue:不存储元素的阻塞队列,每一个生产线程会阻塞到有一个 put 的线程放入元素为止
- LinkedTransferQueue:由链表结构组成的无界阻塞队列
- LinkedBlockingDeque:由链表结构组成的双向阻塞队列
与普通队列(LinkedList、ArrayList等)的不同点在于阻塞队列中阻塞添加和阻塞删除方法,以及线程安全:
- 阻塞添加 put():当阻塞队列元素已满时,添加队列元素的线程会被阻塞,直到队列元素不满时才重新唤醒线程执行
- 阻塞删除 take():在队列元素为空时,删除队列元素的线程将被阻塞,直到队列不为空再执行删除操作(一般会返回被删除的元素)
核心方法
| 方法类型 | 抛出异常 | 特殊值 | 阻塞 | 超时 |
|---|---|---|---|---|
| 插入(尾) | add(e) | offer(e) | put(e) | offer(e,time,unit) |
| 移除(头) | remove() | poll() | take() | poll(time,unit) |
| 检查(队首元素) | element() | peek() | 不可用 | 不可用 |
- 抛出异常组:
- 当阻塞队列满时:在往队列中 add 插入元素会抛出 IIIegalStateException: Queue full
- 当阻塞队列空时:再往队列中 remove 移除元素,会抛出 NoSuchException
- 特殊值组:
- 插入方法:成功 true,失败 false
- 移除方法:成功返回出队列元素,队列没有就返回 null
- 阻塞组:
- 当阻塞队列满时,生产者继续往队列里 put 元素,队列会一直阻塞生产线程直到队列有空间 put 数据或响应中断退出
- 当阻塞队列空时,消费者线程试图从队列里 take 元素,队列会一直阻塞消费者线程直到队列中有可用元素
- 超时退出:当阻塞队列满时,队里会阻塞生产者线程一定时间,超过限时后生产者线程会退出
链表队列
入队出队
LinkedBlockingQueue 源码:
public class LinkedBlockingQueue<E> extends AbstractQueue<E>
			implements BlockingQueue<E>, java.io.Serializable {
	static class Node<E> {
        E item;
        /**
        * 下列三种情况之一
        * - 真正的后继节点
        * - 自己, 发生在出队时
        * - null, 表示是没有后继节点, 是尾节点了
        */
        Node<E> next;

        Node(E x) { item = x; }
    }
}入队:尾插法
-
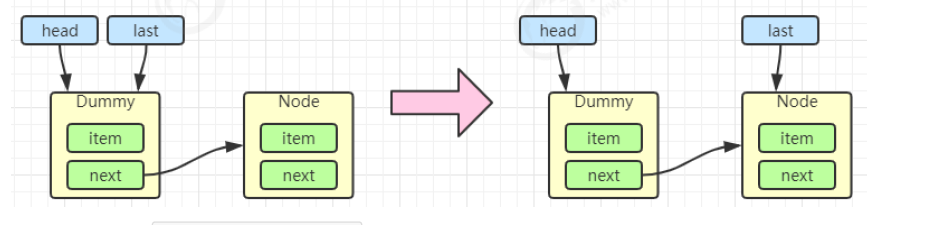
初始化链表
last = head = new Node<E>(null),Dummy 节点用来占位,item 为 nullpublic LinkedBlockingQueue(int capacity) { // 默认是 Integer.MAX_VALUE if (capacity <= 0) throw new IllegalArgumentException(); this.capacity = capacity; last = head = new Node<E>(null); } -
当一个节点入队:
private void enqueue(Node<E> node) {
    // 从右向左计算
    last = last.next = node;
}
-
再来一个节点入队
last = last.next = node
出队:出队头节点,FIFO
-
出队源码:
private E dequeue() { Node<E> h = head; // 获取临头节点 Node<E> first = h.next; // 自己指向自己,help GC h.next = h; head = first; // 出队的元素 E x = first.item; // 【当前节点置为 Dummy 节点】 first.item = null; return x; } -
h = head→first = h.next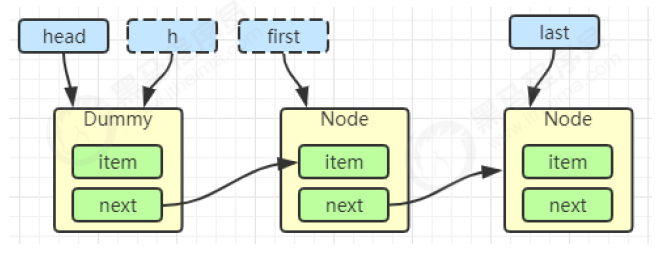
-
h.next = h→head = first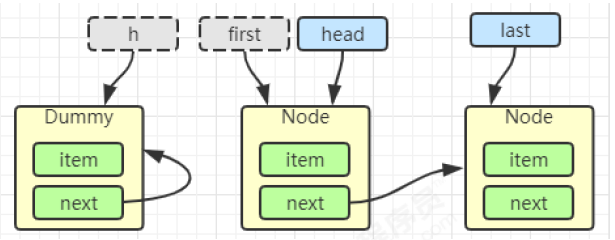
first.item = null:当前节点置为 Dummy 节点
加锁分析
用了两把锁和 dummy 节点:
- 用一把锁,同一时刻,最多只允许有一个线程(生产者或消费者,二选一)执行
- 用两把锁,同一时刻,可以允许两个线程同时(一个生产者与一个消费者)执行
- 消费者与消费者线程仍然串行
- 生产者与生产者线程仍然串行
线程安全分析:
-
当节点总数大于 2 时(包括 dummy 节点),putLock 保证的是 last 节点的线程安全,takeLock 保证的是 head 节点的线程安全,两把锁保证了入队和出队没有竞争
-
当节点总数等于 2 时(即一个 dummy 节点,一个正常节点)这时候,仍然是两把锁锁两个对象,不会竞争
-
当节点总数等于 1 时(就一个 dummy 节点)这时 take 线程会被 notEmpty 条件阻塞,有竞争,会阻塞
// 用于 put(阻塞) offer(非阻塞)
private final ReentrantLock putLock = new ReentrantLock();
private final Condition notFull = putLock.newCondition();	// 阻塞等待不满,说明已经满了

// 用于 take(阻塞) poll(非阻塞)
private final ReentrantLock takeLock = new ReentrantLock();
private final Condition notEmpty = takeLock.newCondition();	// 阻塞等待不空,说明已经是空的
入队出队:
-
put 操作:
public void put(E e) throws InterruptedException {
    // 空指针异常
    if (e == null) throw new NullPointerException();
    int c = -1;
    // 把待添加的元素封装为 node 节点
    Node<E> node = new Node<E>(e);
    // 获取全局生产锁
    final ReentrantLock putLock = this.putLock;
    // count 用来维护元素计数
    final AtomicInteger count = this.count;
    // 获取可打断锁,会抛出异常
    putLock.lockInterruptibly();
    try {
    	// 队列满了等待
        while (count.get() == capacity) {
            // 【等待队列不满时,就可以生产数据】,线程处于 Waiting
            notFull.await();
        }
        // 有空位, 入队且计数加一,尾插法
        enqueue(node);
        // 返回自增前的数字
        c = count.getAndIncrement();
        // put 完队列还有空位, 唤醒其他生产 put 线程,唤醒一个减少竞争
        if (c + 1 < capacity)
            notFull.signal();
    } finally {
        // 解锁
        putLock.unlock();
    }
    // c自增前是0,说明生产了一个元素,唤醒一个 take 线程
    if (c == 0)
        signalNotEmpty();
}
private void signalNotEmpty() { final ReentrantLock takeLock = this.takeLock; takeLock.lock(); try { // 调用 notEmpty.signal(),而不是 notEmpty.signalAll() 是为了减少竞争,因为只剩下一个元素 notEmpty.signal(); } finally { takeLock.unlock(); } } -
take 操作:
public E take() throws InterruptedException {
    E x;
    int c = -1;
    // 元素个数
    final AtomicInteger count = this.count;
    // 获取全局消费锁
    final ReentrantLock takeLock = this.takeLock;
    // 可打断锁
    takeLock.lockInterruptibly();
    try {
        // 没有元素可以出队
        while (count.get() == 0) {
            // 【阻塞等待队列不空,就可以消费数据】,线程处于 Waiting
            notEmpty.await();
        }
        // 出队,计数减一,FIFO,出队头节点
        x = dequeue();
        // 返回自减前的数字
        c = count.getAndDecrement();
        // 队列还有元素
        if (c > 1)
            // 唤醒一个消费take线程
            notEmpty.signal();
    } finally {
        takeLock.unlock();
    }
    // c 是消费前的数据,消费前满了,消费一个后还剩一个空位,唤醒生产线程
    if (c == capacity)
        // 调用的是 notFull.signal() 而不是 notFull.signalAll() 是为了减少竞争
        signalNotFull();
    return x;
}
性能比较
主要列举 LinkedBlockingQueue 与 ArrayBlockingQueue 的性能比较:
- Linked 支持有界,Array 强制有界
- Linked 实现是链表,Array 实现是数组
- Linked 是懒惰的,而 Array 需要提前初始化 Node 数组
- Linked 每次入队会生成新 Node,而 Array 的 Node 是提前创建好的
- Linked 两把锁,Array 一把锁
同步队列
成员属性
SynchronousQueue 是一个不存储元素的 BlockingQueue,每一个生产者必须阻塞匹配到一个消费者
成员变量:
-
运行当前程序的平台拥有 CPU 的数量:
static final int NCPUS = Runtime.getRuntime().availableProcessors() -
指定超时时间后,当前线程最大自旋次数:
// 只有一个 CPU 时自旋次数为 0,所有程序都是串行执行,多核 CPU 时自旋 32 次是一个经验值
static final int maxTimedSpins = (NCPUS < 2) ? 0 : 32;
自旋的原因:线程挂起唤醒需要进行上下文切换,涉及到用户态和内核态的转变,是非常消耗资源的。自旋期间线程会一直检查自己的状态是否被匹配到,如果自旋期间被匹配到,那么直接就返回了,如果自旋次数达到某个指标后,还是会将当前线程挂起
-
未指定超时时间,当前线程最大自旋次数:
static final int maxUntimedSpins = maxTimedSpins * 16; // maxTimedSpins 的 16 倍 -
指定超时限制的阈值,小于该值的线程不会被挂起:
static final long spinForTimeoutThreshold = 1000L; // 纳秒超时时间设置的小于该值,就会被禁止挂起,阻塞再唤醒的成本太高,不如选择自旋空转
-
转换器:
private transient volatile Transferer<E> transferer; abstract static class Transferer<E> { /** * 参数一:可以为 null,null 时表示这个请求是一个 REQUEST 类型的请求,反之是一个 DATA 类型的请求 * 参数二:如果为 true 表示指定了超时时间,如果为 false 表示不支持超时,会一直阻塞到匹配或者被打断 * 参数三:超时时间限制,单位是纳秒 * 返回值:返回值如果不为 null 表示匹配成功,DATA 类型的请求返回当前线程 put 的数据 * 如果返回 null,表示请求超时或被中断 */ abstract E transfer(E e, boolean timed, long nanos); } -
构造方法:
public SynchronousQueue(boolean fair) { // fair 默认 false // 非公平模式实现的数据结构是栈,公平模式的数据结构是队列 transferer = fair ? new TransferQueue<E>() : new TransferStack<E>(); } -
成员方法:
public boolean offer(E e) {
    if (e == null) throw new NullPointerException();
    return transferer.transfer(e, true, 0) != null;
}
public E poll() {
    return transferer.transfer(null, true, 0);
}
非公实现
TransferStack 是非公平的同步队列,因为所有的请求都被压入栈中,栈顶的元素会最先得到匹配,造成栈底的等待线程饥饿
TransferStack 类成员变量:
-
请求类型:
// 表示 Node 类型为请求类型 static final int REQUEST = 0; // 表示 Node类 型为数据类型 static final int DATA = 1; // 表示 Node 类型为匹配中类型 // 假设栈顶元素为 REQUEST-NODE,当前请求类型为 DATA,入栈会修改类型为 FULFILLING 【栈顶 & 栈顶之下的一个node】 // 假设栈顶元素为 DATA-NODE,当前请求类型为 REQUEST,入栈会修改类型为 FULFILLING 【栈顶 & 栈顶之下的一个node】 static final int FULFILLING = 2; -
栈顶元素:
volatile SNode head;
内部类 SNode:
-
成员变量:
static final class SNode { // 指向下一个栈帧 volatile SNode next; // 与当前 node 匹配的节点 volatile SNode match; // 假设当前node对应的线程自旋期间未被匹配成功,那么node对应的线程需要挂起, // 挂起前 waiter 保存对应的线程引用,方便匹配成功后,被唤醒。 volatile Thread waiter; // 数据域,不为空表示当前 Node 对应的请求类型为 DATA 类型,反之则表示 Node 为 REQUEST 类型 Object item; // 表示当前Node的模式 【DATA/REQUEST/FULFILLING】 int mode; } -
构造方法:
SNode(Object item) { this.item = item; } -
设置方法:设置 Node 对象的 next 字段,此处对 CAS 进行了优化,提升了 CAS 的效率
boolean casNext(SNode cmp, SNode val) { //【优化:cmp == next】,可以提升一部分性能。 cmp == next 不相等,就没必要走 cas指令。 return cmp == next && UNSAFE.compareAndSwapObject(this, nextOffset, cmp, val); } -
匹配方法:
boolean tryMatch(SNode s) { // 当前 node 尚未与任何节点发生过匹配,CAS 设置 match 字段为 s 节点,表示当前 node 已经被匹配 if (match == null && UNSAFE.compareAndSwapObject(this, matchOffset, null, s)) { // 当前 node 如果自旋结束,会 park 阻塞,阻塞前将 node 对应的 Thread 保留到 waiter 字段 // 获取当前 node 对应的阻塞线程 Thread w = waiter; // 条件成立说明 node 对应的 Thread 正在阻塞 if (w != null) { waiter = null; // 使用 unpark 方式唤醒线程 LockSupport.unpark(w); } return true; } // 匹配成功返回 true return match == s; } -
取消方法:
// 取消节点的方法
void tryCancel() {
    // match 字段指向自己,表示这个 node 是取消状态,取消状态的 node,最终会被强制移除出栈
    UNSAFE.compareAndSwapObject(this, matchOffset, null, this);
}

boolean isCancelled() {
    return match == this;
}
TransferStack 类成员方法:
-
snode():填充节点方法
static SNode snode(SNode s, Object e, SNode next, int mode) { // 引用指向空时,snode 方法会创建一个 SNode 对象 if (s == null) s = new SNode(e); // 填充数据 s.mode = mode; s.next = next; return s; } -
transfer():核心方法,请求匹配出栈,不匹配阻塞
E transfer(E e, boolean timed, long nanos) { // 包装当前线程的 node SNode s = null; // 根据元素判断当前的请求类型 int mode = (e == null) ? REQUEST : DATA; // 自旋 for (;;) { // 获取栈顶指针 SNode h = head; // 【CASE1】:当前栈为空或者栈顶 node 模式与当前请求模式一致无法匹配,做入栈操作 if (h == null || h.mode == mode) { // 当前请求是支持超时的,但是 nanos <= 0 说明这个请求不支持 “阻塞等待” if (timed && nanos <= 0) { // 栈顶元素是取消状态 if (h != null && h.isCancelled()) // 栈顶出栈,设置新的栈顶 casHead(h, h.next); else // 表示【匹配失败】 return null; // 入栈 } else if (casHead(h, s = snode(s, e, h, mode))) { // 等待被匹配的逻辑,正常情况返回匹配的节点;取消情况返回当前节点,就是 s SNode m = awaitFulfill(s, timed, nanos); // 说明当前 node 是【取消状态】 if (m == s) { // 将取消节点出栈 clean(s); return null; } // 执行到这说明【匹配成功】了 // 栈顶有节点并且 匹配节点还未出栈,需要协助出栈 if ((h = head) != null && h.next == s) casHead(h, s.next); // 当前 node 模式为 REQUEST 类型,返回匹配节点的 m.item 数据域 // 当前 node 模式为 DATA 类型:返回 node.item 数据域,当前请求提交的数据 e return (E) ((mode == REQUEST) ? m.item : s.item); } // 【CASE2】:逻辑到这说明请求模式不一致,如果栈顶不是 FULFILLING 说明没被其他节点匹配,【当前可以匹配】 } else if (!isFulfilling(h.mode)) { // 头节点是取消节点,match 指向自己,协助出栈 if (h.isCancelled()) casHead(h, h.next); // 入栈当前请求的节点 else if (casHead(h, s=snode(s, e, h, FULFILLING|mode))) { for (;;) { // m 是 s 的匹配的节点 SNode m = s.next; // m 节点在 awaitFulfill 方法中被中断,clean 了自己 if (m == null) { // 清空栈 casHead(s, null); s = null; // 返回到外层自旋中 break; } // 获取匹配节点的下一个节点 SNode mn = m.next; // 尝试匹配,【匹配成功】,则将 fulfilling 和 m 一起出栈,并且唤醒被匹配的节点的线程 if (m.tryMatch(s)) { casHead(s, mn); return (E) ((mode == REQUEST) ? m.item : s.item); } else // 匹配失败,出栈 m s.casNext(m, mn); } } // 【CASE3】:栈顶模式为 FULFILLING 模式,表示【栈顶和栈顶下面的节点正在发生匹配】,当前请求需要做协助工作 } else { // h 表示的是 fulfilling 节点,m 表示 fulfilling 匹配的节点 SNode m = h.next; if (m == null) // 清空栈 casHead(h, null); else { SNode mn = m.next; // m 和 h 匹配,唤醒 m 中的线程 if (m.tryMatch(h)) casHead(h, mn); else h.casNext(m, mn); } } } } -
awaitFulfill():阻塞当前线程等待被匹配,返回匹配的节点,或者被取消的节点
SNode awaitFulfill(SNode s, boolean timed, long nanos) {
    // 等待的截止时间
    final long deadline = timed ? System.nanoTime() + nanos : 0L;
    // 当前线程
    Thread w = Thread.currentThread();
    // 表示当前请求线程在下面的 for(;;) 自旋检查的次数
    int spins = (shouldSpin(s) ? (timed ? maxTimedSpins : maxUntimedSpins) : 0);
    // 自旋检查逻辑:是否匹配、是否超时、是否被中断
    for (;;) {
        // 当前线程收到中断信号,需要设置 node 状态为取消状态
        if (w.isInterrupted())
            s.tryCancel();
        // 获取与当前 s 匹配的节点
        SNode m = s.match;
        if (m != null)
            // 可能是正常的匹配的,也可能是取消的
            return m;
        // 执行了超时限制就判断是否超时
        if (timed) {
            nanos = deadline - System.nanoTime();
            // 【超时了,取消节点】
            if (nanos <= 0L) {
                s.tryCancel();
                continue;
            }
        }
        // 说明当前线程还可以进行自旋检查
        if (spins > 0)
            // 自旋一次 递减 1
            spins = shouldSpin(s) ? (spins - 1) : 0;
        // 说明没有自旋次数了
        else if (s.waiter == null)
            //【把当前 node 对应的 Thread 保存到 node.waiter 字段中,要阻塞了】
            s.waiter = w;
        // 没有超时限制直接阻塞
        else if (!timed)
            LockSupport.park(this);
        // nanos > 1000 纳秒的情况下,才允许挂起当前线程
        else if (nanos > spinForTimeoutThreshold)
            LockSupport.parkNanos(this, nanos);
    }
}
boolean shouldSpin(SNode s) { // 获取栈顶 SNode h = head; // 条件一成立说明当前 s 就是栈顶,允许自旋检查 // 条件二成立说明当前 s 节点自旋检查期间,又来了一个与当前 s 节点匹配的请求,双双出栈后条件会成立 // 条件三成立前提当前 s 不是栈顶元素,并且当前栈顶正在匹配中,这种状态栈顶下面的元素,都允许自旋检查 return (h == s || h == null || isFulfilling(h.mode)); } -
clear():指定节点出栈
void clean(SNode s) {
    // 清空数据域和关联线程
    s.item = null;
    s.waiter = null;

	// 获取取消节点的下一个节点
    SNode past = s.next;
    // 判断后继节点是不是取消节点,是就更新 past
    if (past != null && past.isCancelled())
        past = past.next;

    SNode p;
    // 从栈顶开始向下检查,【将栈顶开始向下的 取消状态 的节点全部清理出去】,直到碰到 past 或者不是取消状态为止
    while ((p = head) != null && p != past && p.isCancelled())
        // 修改的是内存地址对应的值,p 指向该内存地址所以数据一直在变化
        casHead(p, p.next);
	// 说明中间遇到了不是取消状态的节点,继续迭代下去
    while (p != null && p != past) {
        SNode n = p.next;
        if (n != null && n.isCancelled())
            p.casNext(n, n.next);
        else
            p = n;
    }
}
公平实现
TransferQueue 是公平的同步队列,采用 FIFO 的队列实现,请求节点与队尾模式不同,需要与队头发生匹配
TransferQueue 类成员变量:
-
指向队列的 dummy 节点:
transient volatile QNode head; -
指向队列的尾节点:
transient volatile QNode tail; -
被清理节点的前驱节点:
transient volatile QNode cleanMe;入队操作是两步完成的,第一步是 t.next = newNode,第二步是 tail = newNode,所以队尾节点出队,是一种非常特殊的情况
TransferQueue 内部类:
-
QNode:
static final class QNode {
    // 指向当前节点的下一个节点
    volatile QNode next;
    // 数据域,Node 代表的是 DATA 类型 item 表示数据,否则 Node 代表的 REQUEST 类型,item == null
    volatile Object item;
    // 假设当前 node 对应的线程自旋期间未被匹配成功,那么 node 对应的线程需要挂起,
    // 挂起前 waiter 保存对应的线程引用,方便匹配成功后被唤醒。
    volatile Thread waiter;
    // true 当前 Node 是一个 DATA 类型,false 表示当前 Node 是一个 REQUEST 类型
    final boolean isData;

	// 构建方法
    QNode(Object item, boolean isData) {
        this.item = item;
        this.isData = isData;
    }

    // 尝试取消当前 node,取消状态的 node 的 item 域指向自己
    void tryCancel(Object cmp) {
        UNSAFE.compareAndSwapObject(this, itemOffset, cmp, this);
    }

    // 判断当前 node 是否为取消状态
    boolean isCancelled() {
        return item == this;
    }

    // 判断当前节点是否 “不在” 队列内,当 next 指向自己时,说明节点已经出队。
    boolean isOffList() {
        return next == this;
    }
}
TransferQueue 类成员方法:
-
设置头尾节点:
void advanceHead(QNode h, QNode nh) { // 设置头指针指向新的节点, if (h == head && UNSAFE.compareAndSwapObject(this, headOffset, h, nh)) // 老的头节点出队 h.next = h; } void advanceTail(QNode t, QNode nt) { if (tail == t) // 更新队尾节点为新的队尾 UNSAFE.compareAndSwapObject(this, tailOffset, t, nt); } -
transfer():核心方法
E transfer(E e, boolean timed, long nanos) { // s 指向当前请求对应的 node QNode s = null; // 是否是 DATA 类型的请求 boolean isData = (e != null); // 自旋 for (;;) { QNode t = tail; QNode h = head; if (t == null || h == null) continue; // head 和 tail 同时指向 dummy 节点,说明是空队列 // 队尾节点与当前请求类型是一致的情况,说明阻塞队列中都无法匹配, if (h == t || t.isData == isData) { // 获取队尾 t 的 next 节点 QNode tn = t.next; // 多线程环境中其他线程可能修改尾节点 if (t != tail) continue; // 已经有线程入队了,更新 tail if (tn != null) { advanceTail(t, tn); continue; } // 允许超时,超时时间小于 0,这种方法不支持阻塞等待 if (timed && nanos <= 0) return null; // 创建 node 的逻辑 if (s == null) s = new QNode(e, isData); // 将 node 添加到队尾 if (!t.casNext(null, s)) continue; // 更新队尾指针 advanceTail(t, s); // 当前节点 等待匹配.... Object x = awaitFulfill(s, e, timed, nanos); // 说明【当前 node 状态为 取消状态】,需要做出队逻辑 if (x == s) { clean(t, s); return null; } // 说明当前 node 仍然在队列内,匹配成功,需要做出队逻辑 if (!s.isOffList()) { // t 是当前 s 节点的前驱节点,判断 t 是不是头节点,是就更新 dummy 节点为 s 节点 advanceHead(t, s); // s 节点已经出队,所以需要把它的 item 域设置为它自己,表示它是个取消状态 if (x != null) s.item = s; s.waiter = null; } return (x != null) ? (E)x : e; // 队尾节点与当前请求节点【互补匹配】 } else { // h.next 节点,【请求节点与队尾模式不同,需要与队头发生匹配】,TransferQueue 是一个【公平模式】 QNode m = h.next; // 并发导致其他线程修改了队尾节点,或者已经把 head.next 匹配走了 if (t != tail || m == null || h != head) continue; // 获取匹配节点的数据域保存到 x Object x = m.item; // 判断是否匹配成功 if (isData == (x != null) || x == m || !m.casItem(x, e)) { advanceHead(h, m); continue; } // 【匹配完成】,将头节点出队,让这个新的头结点成为 dummy 节点 advanceHead(h, m); // 唤醒该匹配节点的线程 LockSupport.unpark(m.waiter); return (x != null) ? (E)x : e; } } } -
awaitFulfill():阻塞当前线程等待被匹配
Object awaitFulfill(QNode s, E e, boolean timed, long nanos) {
    // 表示等待截止时间
    final long deadline = timed ? System.nanoTime() + nanos : 0L;
    Thread w = Thread.currentThread();
    // 自选检查的次数
    int spins = ((head.next == s) ? (timed ? maxTimedSpins : maxUntimedSpins) : 0);
    for (;;) {
        // 被打断就取消节点
        if (w.isInterrupted())
            s.tryCancel(e);
        // 获取当前 Node 数据域
        Object x = s.item;

        // 当前请求为 DATA 模式时:e 请求带来的数据
        // s.item 修改为 this,说明当前 QNode 对应的线程 取消状态
        // s.item 修改为 null 表示已经有匹配节点了,并且匹配节点拿走了 item 数据

        // 当前请求为 REQUEST 模式时:e == null
        // s.item 修改为 this,说明当前 QNode 对应的线程 取消状态
        // s.item != null 且 item != this  表示当前 REQUEST 类型的 Node 已经匹配到 DATA 了
        if (x != e)
            return x;
        // 超时检查
        if (timed) {
            nanos = deadline - System.nanoTime();
            if (nanos <= 0L) {
                s.tryCancel(e);
                continue;
            }
        }
        // 自旋次数减一
        if (spins > 0)
            --spins;
        // 没有自旋次数了,把当前线程封装进去 waiter
        else if (s.waiter == null)
            s.waiter = w;
        // 阻塞
        else if (!timed)
            LockSupport.park(this);
        else if (nanos > spinForTimeoutThreshold)
            LockSupport.parkNanos(this, nanos);
    }
}