18-非阻塞队列
NoBlocking
非阻塞队列
并发编程中,需要用到安全的队列,实现安全队列可以使用 2 种方式:
- 加锁,这种实现方式是阻塞队列
- 使用循环 CAS 算法实现,这种方式是非阻塞队列
ConcurrentLinkedQueue 是一个基于链接节点的无界线程安全队列,采用先进先出的规则对节点进行排序,当添加一个元素时,会添加到队列的尾部,当获取一个元素时,会返回队列头部的元素
补充:ConcurrentLinkedDeque 是双向链表结构的无界并发队列
ConcurrentLinkedQueue 使用约定:
- 不允许 null 入列
- 队列中所有未删除的节点的 item 都不能为 null 且都能从 head 节点遍历到
- 删除节点是将 item 设置为 null,队列迭代时跳过 item 为 null 节点
- head 节点跟 tail 不一定指向头节点或尾节点,可能存在滞后性
ConcurrentLinkedQueue 由 head 节点和 tail 节点组成,每个节点由节点元素和指向下一个节点的引用组成,组成一张链表结构的队列
private transient volatile Node<E> head;
private transient volatile Node<E> tail;

private static class Node<E> {
    volatile E item;
    volatile Node<E> next;
    //.....
}
构造方法
-
无参构造方法:
public ConcurrentLinkedQueue() { // 默认情况下 head 节点存储的元素为空,dummy 节点,tail 节点等于 head 节点 head = tail = new Node<E>(null); } -
有参构造方法
public ConcurrentLinkedQueue(Collection<? extends E> c) {
    Node<E> h = null, t = null;
    // 遍历节点
    for (E e : c) {
        checkNotNull(e);
        Node<E> newNode = new Node<E>(e);
        if (h == null)
            h = t = newNode;
        else {
            // 单向链表
            t.lazySetNext(newNode);
            t = newNode;
        }
    }
    if (h == null)
        h = t = new Node<E>(null);
    head = h;
    tail = t;
}
入队方法
与传统的链表不同,单线程入队的工作流程:
- 将入队节点设置成当前队列尾节点的下一个节点
- 更新 tail 节点,如果 tail 节点的 next 节点不为空,则将入队节点设置成 tail 节点;如果 tail 节点的 next 节点为空,则将入队节点设置成 tail 的 next 节点,所以 tail 节点不总是尾节点,存在滞后性
public boolean offer(E e) {
    checkNotNull(e);
    // 创建入队节点
    final Node<E> newNode = new Node<E>(e);

    // 循环 CAS 直到入队成功
    for (Node<E> t = tail, p = t;;) {
        // p 用来表示队列的尾节点,初始情况下等于 tail 节点,q 是 p 的 next 节点
        Node<E> q = p.next;
        // 条件成立说明 p 是尾节点
        if (q == null) {
            // p 是尾节点,设置 p 节点的下一个节点为新节点
            // 设置成功则 casNext 返回 true,否则返回 false,说明有其他线程更新过尾节点,继续寻找尾节点,继续 CAS
            if (p.casNext(null, newNode)) {
                // 首次添加时,p 等于 t,不进行尾节点更新,所以尾节点存在滞后性
                if (p != t)
                    // 将 tail 设置成新入队的节点,设置失败表示其他线程更新了 tail 节点
                    casTail(t, newNode);
                return true;
            }
        }
        else if (p == q)
            // 当 tail 不指向最后节点时,如果执行出列操作,可能将 tail 也移除,tail 不在链表中
        	// 此时需要对 tail 节点进行复位,复位到 head 节点
            p = (t != (t = tail)) ? t : head;
        else
            // 推动 tail 尾节点往队尾移动
            p = (p != t && t != (t = tail)) ? t : q;
    }
}
图解入队:
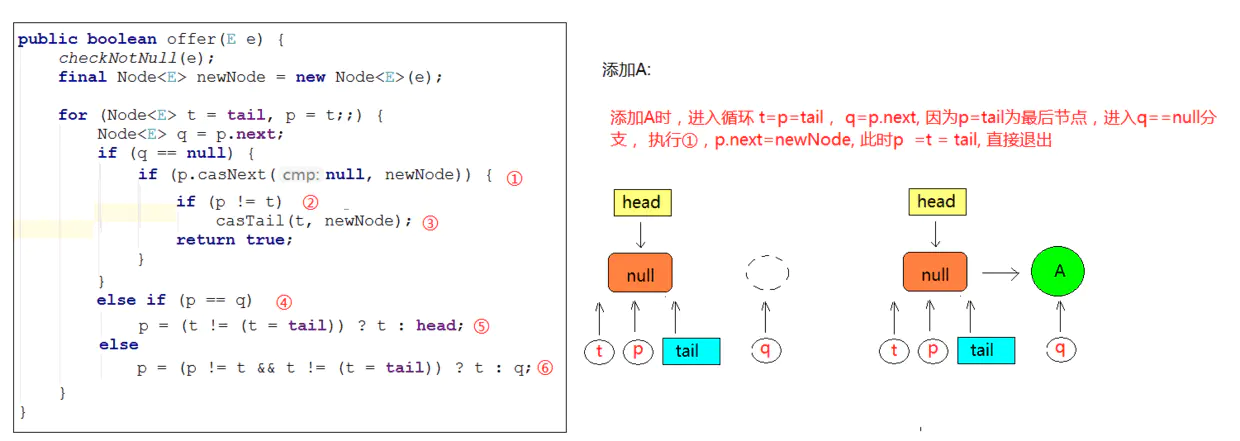
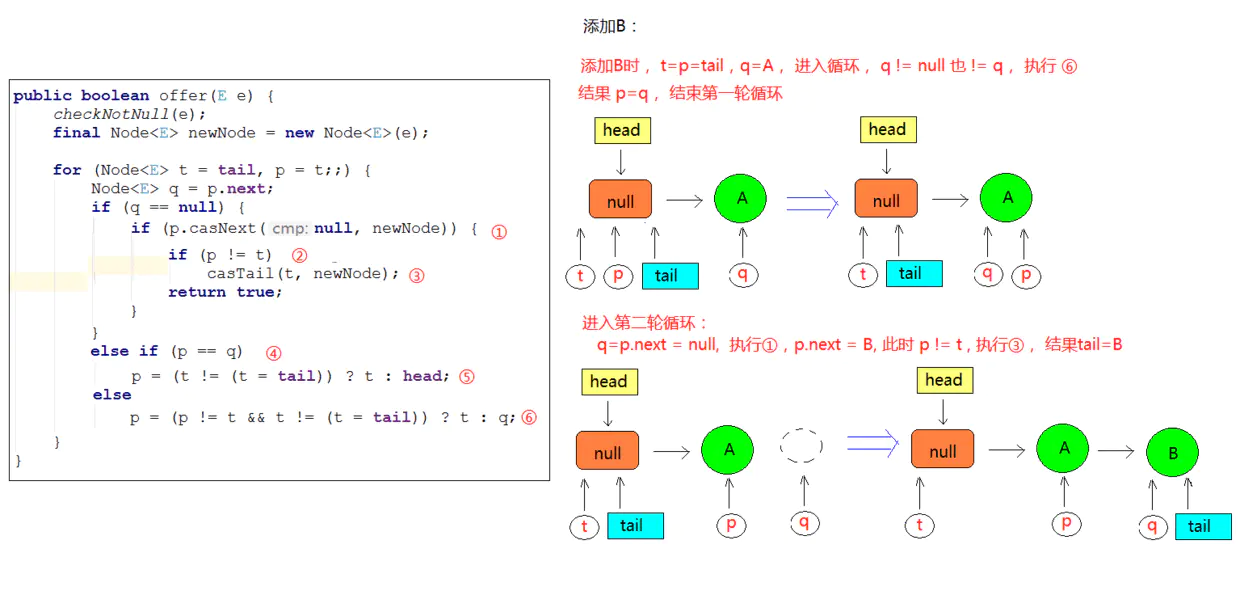
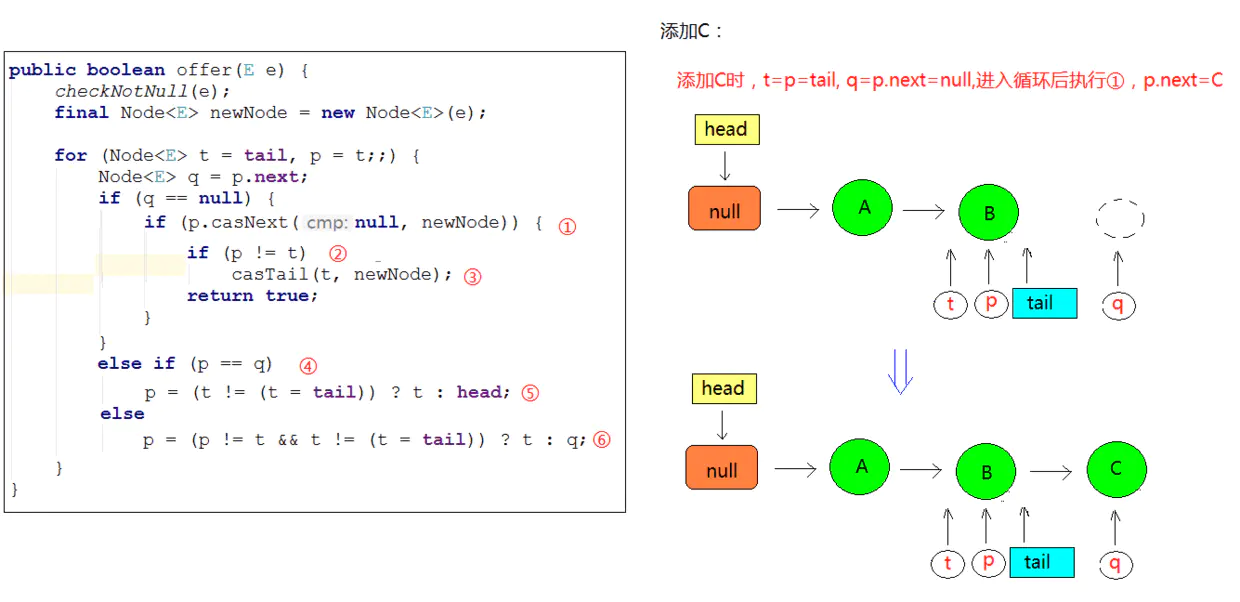
当 tail 节点和尾节点的距离大于等于 1 时(每入队两次)更新 tail,可以减少 CAS 更新 tail 节点的次数,提高入队效率
线程安全问题:
- 线程 1 线程 2 同时入队,无论从哪个位置开始并发入队,都可以循环 CAS,直到入队成功,线程安全
- 线程 1 遍历,线程 2 入队,所以造成 ConcurrentLinkedQueue 的 size 是变化,需要加锁保证安全
- 线程 1 线程 2 同时出列,线程也是安全的
出队方法
出队列的就是从队列里返回一个节点元素,并清空该节点对元素的引用,并不是每次出队都更新 head 节点
- 当 head 节点里有元素时,直接弹出 head 节点里的元素,而不会更新 head 节点
- 当 head 节点里没有元素时,出队操作才会更新 head 节点
批处理方式可以减少使用 CAS 更新 head 节点的消耗,从而提高出队效率
public E poll() {
    restartFromHead:
    for (;;) {
        // p 节点表示首节点,即需要出队的节点,FIFO
        for (Node<E> h = head, p = h, q;;) {
            E item = p.item;
			// 如果 p 节点的元素不为 null,则通过 CAS 来设置 p 节点引用元素为 null,成功返回 item
            if (item != null && p.casItem(item, null)) {
                if (p != h)
                   	// 对 head 进行移动
                    updateHead(h, ((q = p.next) != null) ? q : p);
                return item;
            }
           	// 逻辑到这说明头节点的元素为空或头节点发生了变化,头节点被另外一个线程修改了
            // 那么获取 p 节点的下一个节点,如果 p 节点的下一节点也为 null,则表明队列已经空了
            else if ((q = p.next) == null) {
                updateHead(h, p);
                return null;
            }
      		// 第一轮操作失败,下一轮继续,调回到循环前
            else if (p == q)
                continue restartFromHead;
            // 如果下一个元素不为空,则将头节点的下一个节点设置成头节点
            else
                p = q;
        }
    }
}
final void updateHead(Node<E> h, Node<E> p) {
    if (h != p && casHead(h, p))
        // 将旧结点 h 的 next 域指向为 h,help gc
        h.lazySetNext(h);
}
在更新完 head 之后,会将旧的头结点 h 的 next 域指向为 h,图中所示的虚线也就表示这个节点的自引用,被移动的节点(item 为 null 的节点)会被 GC 回收
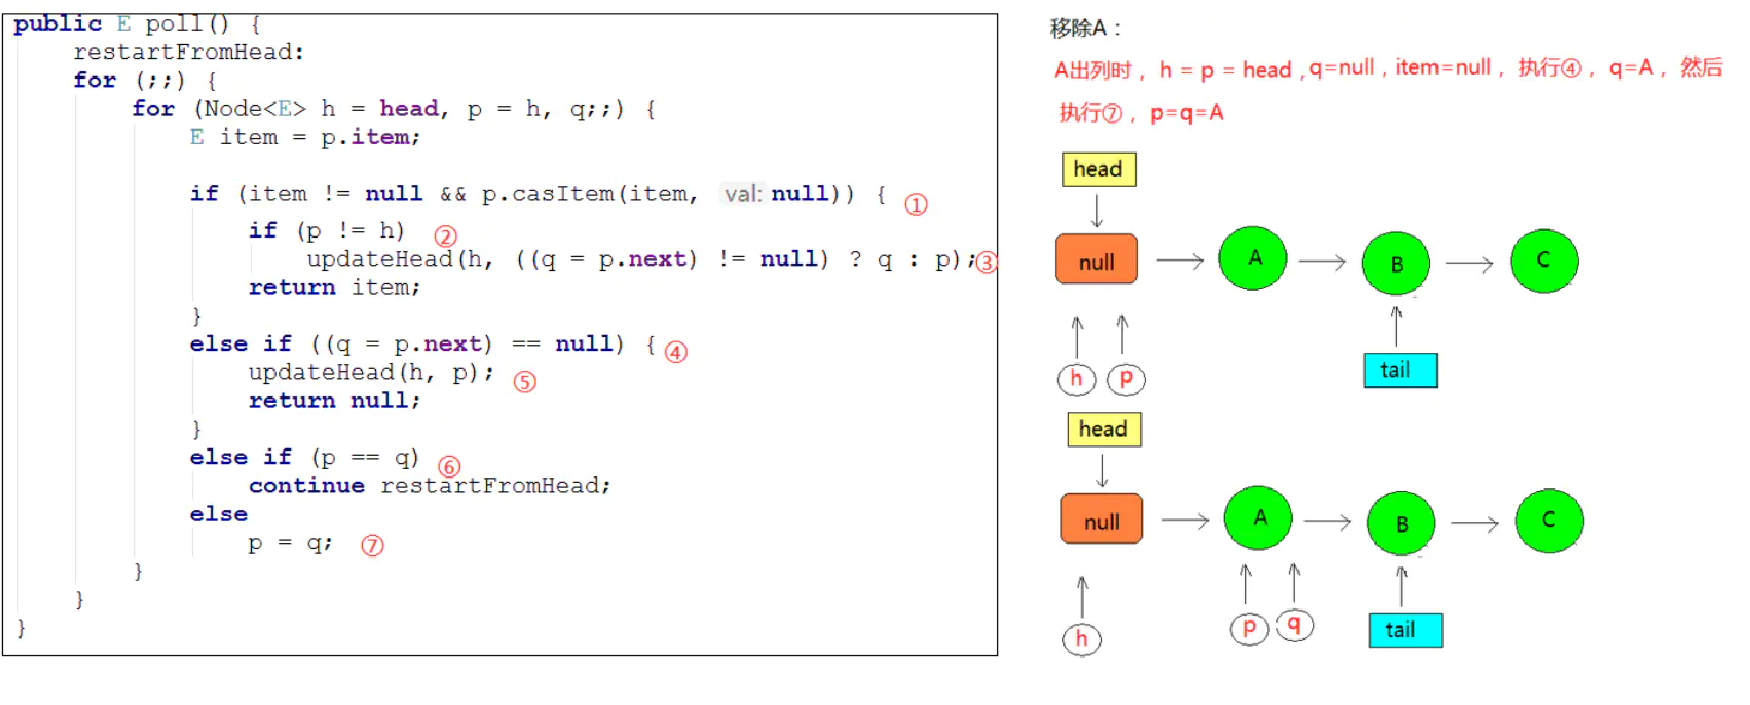
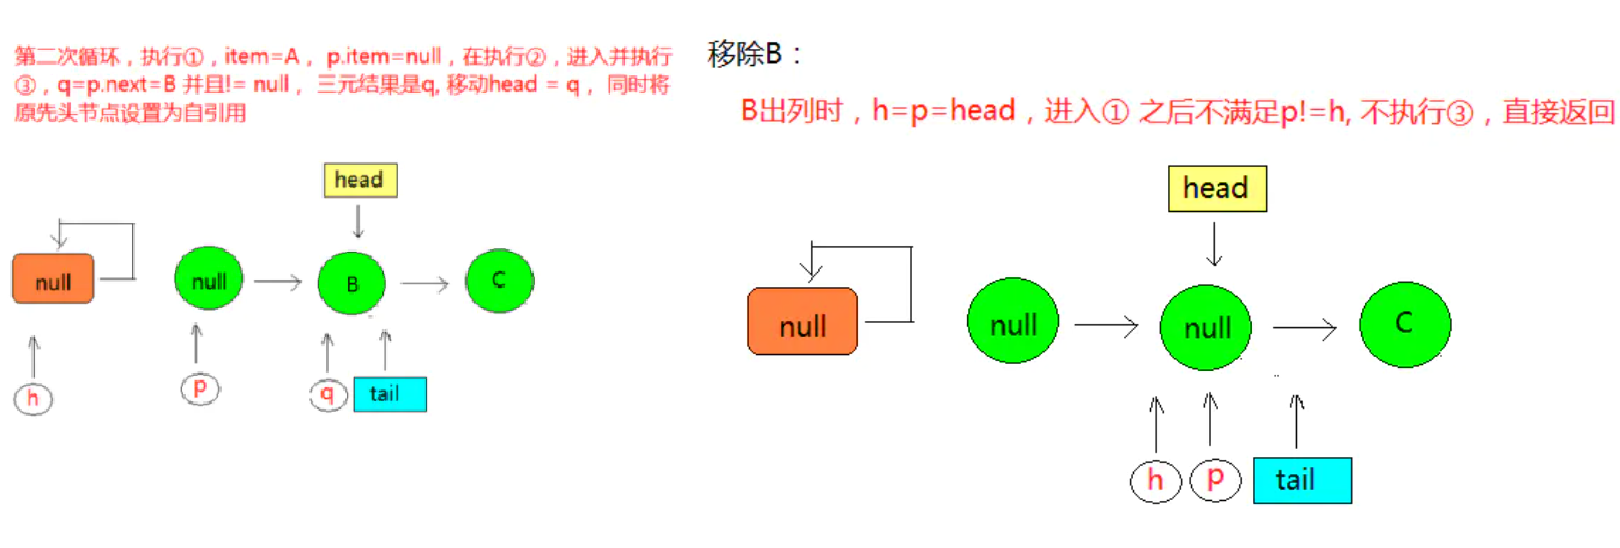
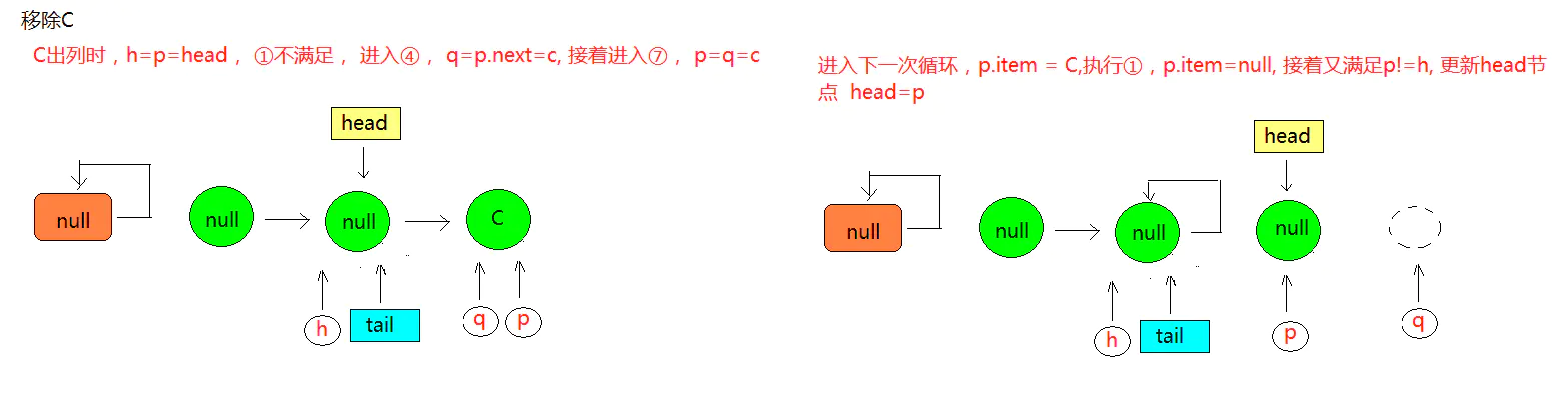
如果这时,有一个线程来添加元素,通过 tail 获取的 next 节点则仍然是它本身,这就出现了p == q 的情况,出现该种情况之后,则会触发执行 head 的更新,将 p 节点重新指向为 head
参考文章:https://www.jianshu.com/p/231caf90f30b
成员方法
-
peek():会改变 head 指向,执行 peek() 方法后 head 会指向第一个具有非空元素的节点
// 获取链表的首部元素,只读取而不移除 public E peek() { restartFromHead: for (;;) { for (Node<E> h = head, p = h, q;;) { E item = p.item; if (item != null || (q = p.next) == null) { // 更改h的位置为非空元素节点 updateHead(h, p); return item; } else if (p == q) continue restartFromHead; else p = q; } } } -
size():用来获取当前队列的元素个数,因为整个过程都没有加锁,在并发环境中从调用 size 方法到返回结果期间有可能增删元素,导致统计的元素个数不精确
public int size() { int count = 0; // first() 获取第一个具有非空元素的节点,若不存在,返回 null // succ(p) 方法获取 p 的后继节点,若 p == p.next,则返回 head // 类似遍历链表 for (Node<E> p = first(); p != null; p = succ(p)) if (p.item != null) // 最大返回Integer.MAX_VALUE if (++count == Integer.MAX_VALUE) break; return count; } -
remove():移除元素
public boolean remove(Object o) {
    // 删除的元素不能为null
    if (o != null) {
        Node<E> next, pred = null;
        for (Node<E> p = first(); p != null; pred = p, p = next) {
            boolean removed = false;
            E item = p.item;
            // 节点元素不为null
            if (item != null) {
                // 若不匹配,则获取next节点继续匹配
                if (!o.equals(item)) {
                    next = succ(p);
                    continue;
                }
                // 若匹配,则通过 CAS 操作将对应节点元素置为 null
                removed = p.casItem(item, null);
            }
            // 获取删除节点的后继节点
            next = succ(p);
            // 将被删除的节点移除队列
            if (pred != null && next != null) // unlink
                pred.casNext(p, next);
            if (removed)
                return true;
        }
    }
    return false;
}